Пилот обычно собирают на API одного провайдера и одной большой модели, и для демо этого хватает. В продакшене у такой схемы проявляются три проблемы.
Большая модель отвечает медленно, когда промпты длинные, а пользователей много. В часы пик провайдер троттлит запросы: отклоняет или откладывает их из-за нехватки мощностей. А дорогая генеративная модель тратит токены на задачи, где нужно выбрать один вариант из пяти.
Каждый из трёх гайдов AWS закрывает одну из этих проблем. В
России Bedrock недоступен, но инженерные проблемы те же, поэтому для каждого гайда я отмечаю, что из него применимо у нас. ###
Одна модель на двух нодах: prefill и decode раздельно Ответ LLM строится в два этапа.
На первом, prefill, модель за один проход читает весь промпт: инструкцию, документы из RAG, историю диалога.
Этот этап упирается в вычислительную мощность GPU.
На втором, decode, модель генерирует ответ по одному токену, и здесь узкое место - пропускная способность памяти.
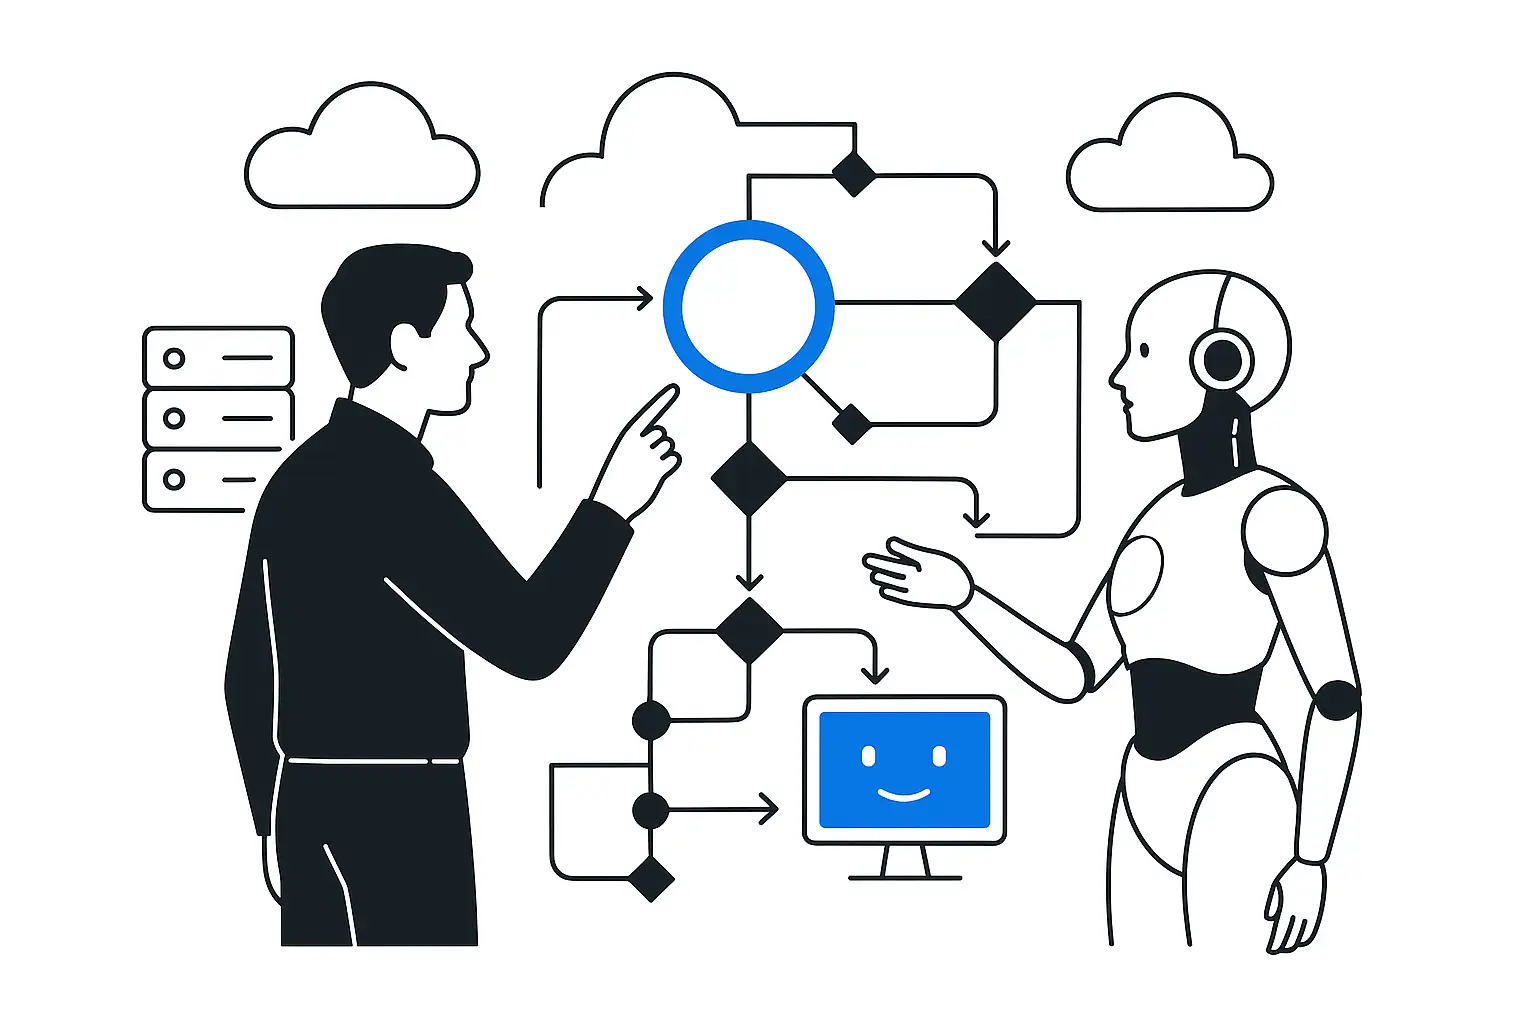
Если оба этапа работают на одной видеокарте, длинный промпт одного пользователя тормозит генерацию у остальных. В гайде AWS модель разворачивают в Kubernetes (Amazon EKS) на двух GPU-нодах с помощью контейнеров Ray LLM.
Одна нода выполняет только prefill, вторая только decode.
Снаружи это один OpenAI-совместимый endpoint, поэтому код приложения менять не нужно.
Та же схема подходит для тензорного, конвейерного и data-параллелизма, когда модель режут по слоям или копируют на несколько машин.
Для бизнеса вывод такой: если у вас RAG по внутренним регламентам и промпт занимает десятки страниц, задержка ответа зависит от того, как разведены эти два этапа, сильнее, чем от размера модели. ###
Ёмкость региона заканчивается в часы пик
Второй гайд прямо называет проблему: когда спрос в регионе превышает локальные мощности, запросы начинают троттлиться. AWS решает это через global cross-Region inference.
Запрос приходит в ваш регион, Bedrock отправляет его туда, где есть свободные GPU, а мониторинг и права доступа остаются в исходном регионе.
Так GPT-6 Sol и GPT-6 Luna доступны из пяти регионов (Таиланд, Малайзия, Сингапур, Индонезия, Тайвань), а GPT-6 Astra - из Сингапура. У российской компании задача та же, но ограничения другие: персональные данные по 152-ФЗ нельзя отправлять куда угодно.
Поэтому в проектах мы строим маршрутизацию сами.
Запрос проходит через LLM & Security Gateway: шлюз маскирует персональные данные, выбирает модель по типу задачи и при отказе переключает запрос с GigaChat на YandexGPT или на собственный Qwen либо Llama в контуре заказчика.
Приложение работает с одним API и не знает, какая модель ему ответила. ###
Многим задачам генератор текста не нужен
Третий гайд я считаю самым недооценённым
AWS выделяет класс decision models - модели, которые выдают оценки по фиксированному набору вариантов вместо свободного текста.
Такие модели маршрутизируют запросы, выбирают следующее действие агента, применяют решение по политике.
Их квантуют, то есть сжимают веса до 4-8 бит, и запускают через llama.cpp на обычных CPU. В наших проектах по товарным каталогам такие задачи встречаются постоянно: отнести товар к узлу таксономии, заполнить фасет из списка допустимых значений, решить, нужен ли ручной override тега.
Всё это классификация по закрытому списку.
Отправлять её во флагманскую модель - как вызывать архитектора, чтобы он выбрал цвет папки.
Маленькая модель на CPU отвечает быстрее и стоит дешевле, а раз ей не нужен GPU, её проще развернуть внутри периметра заказчика.