-
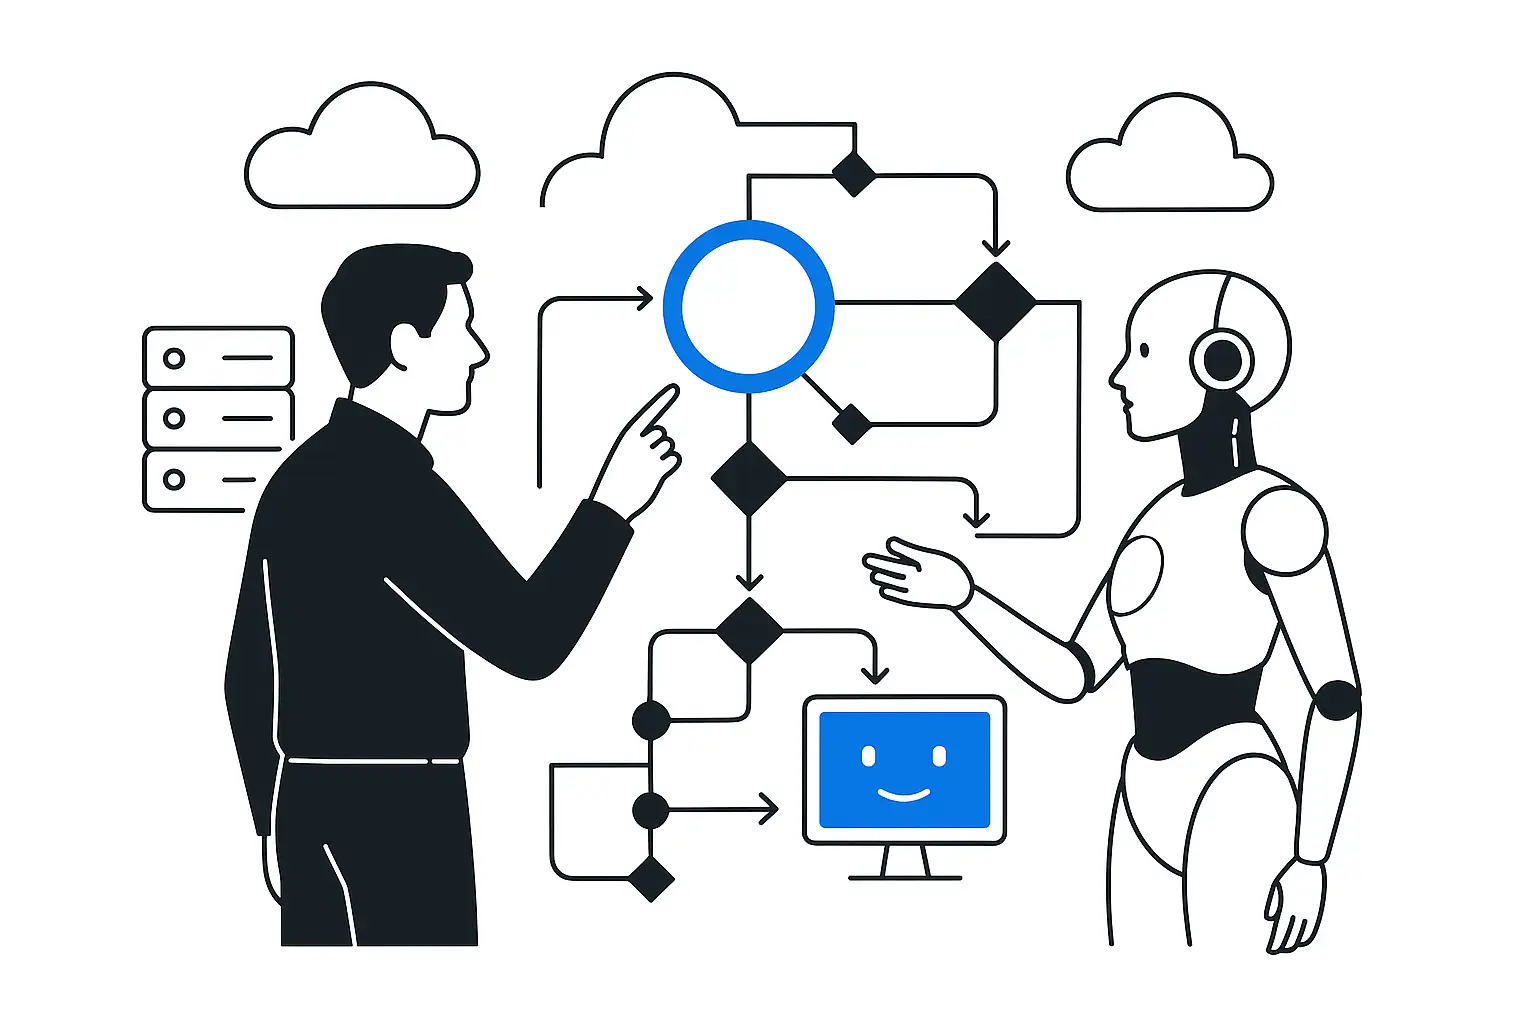
Риск снимают слоями архитектуры, и выбор «правильного» вендора здесь ничего не гарантирует. - Шлюз перед моделями.
-
Приложения обращаются к LLM через единый шлюз.
-
Смена провайдера или модели меняет конфигурацию шлюза, а код сервисов остаётся прежним.
-
Так устроен наш LLM & Security Gateway: он же ведёт учёт запросов и фильтрует чувствительные данные. - Версия модели рядом с вектором. В RAG-системе каждый вектор хранится с идентификатором модели и версии.
-
Пересчёт тогда запускается порциями в фоне, и поиск не останавливается. - Интеграции через стандартные протоколы.
-
Инструменты для агентов публикуются через MCP, обмен между системами идёт через Apache Kafka.
-
Рантайм сервиса (Node.js, Python или C#) можно заменить без пересмотра контрактов. - Открытые веса для больших массивов данных.
-
Для больших массивов эмбеддингов открытая модель с понятной лицензией (Qwen, Llama, Gemma) обходится дешевле, чем зависимость от хостинга, который могут закрыть.
-
Такая архитектура выглядит скучно, и цель у неё конкретная: если через год вендора купят или поднимут цену, переезд должен стоить недели работы одной команды, а квартал работы нескольких команд мы в этот расчёт не допускаем.