GenAI: модель - сырьё, результат делает уровень кастомизации

AWS показал спектр кастомизации GenAI. Разбираем, почему доступ к Claude или Llama не даёт результата и где бизнес теряет деньги на выборе рычага.

  • Доступ к модели ничего не решает
  • Где компании чаще всего теряют деньги
  • Спектр решений на практике
  • Инфраструктура вокруг модели решает не меньше самой модели

Доступ к модели ничего не решает

  1. AWS выпустил разбор спектра кастомизации generative AI: от промпт-инжиниринга до кастомных моделей на Bedrock.

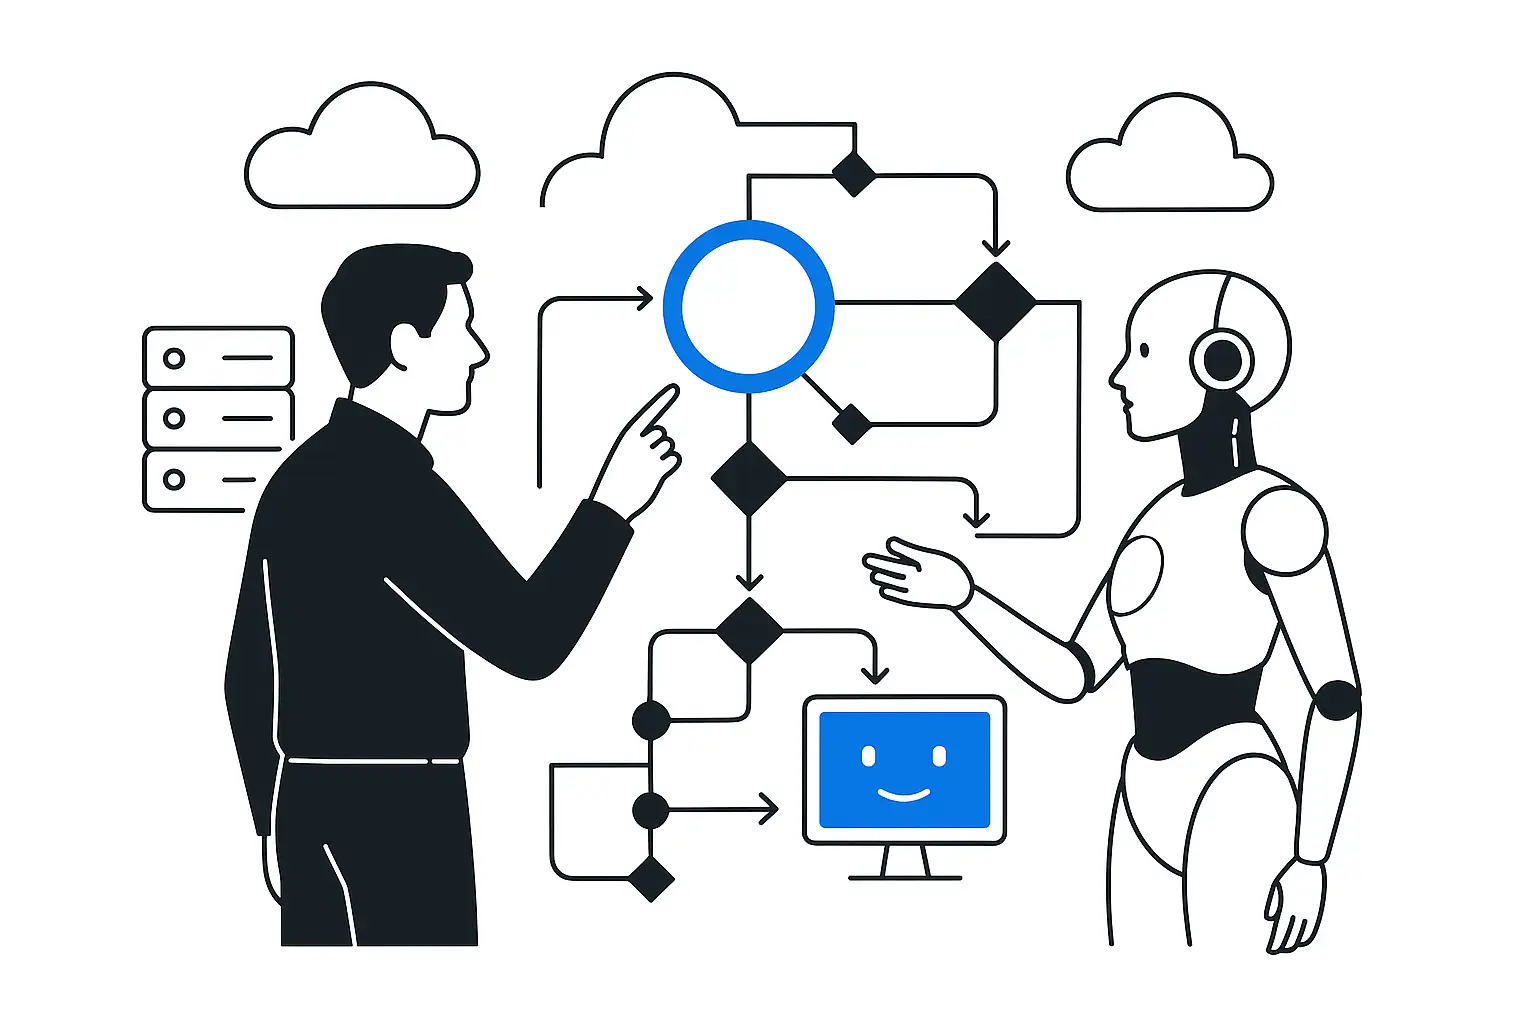
  2. Тезис неприятный для многих CTO: доступ к Anthropic Claude, Amazon Nova или Llama через API сам по себе результата не даёт. Bedrock даёт доступ к десятку моделей и инфраструктуре под чат-боты, кодовых ассистентов, обработку документов и автономных агентов - одинаково всем клиентам AWS.

  3. Разницу между компанией, которая получает от GenAI измеримый результат, и компанией, которая получает демо для внутренней презентации, создаёт метод интеграции модели в бизнес-процесс.

  4. Это решение требует инженерной квалификации команды, которая умеет выбрать рычаг под задачу.

Где компании чаще всего теряют деньги

Типичная ошибка - прыгать сразу к дообученной кастомной модели там, где хватило бы промпт-инжиниринга с грамотным контекстом. Дообучение стоит недели инженерного времени, требует размеченного датасета и цикла переобучения при каждом изменении бизнес-правил. Обратная ошибка - оставлять сложную предметную область на голом промптинге без RAG и без проверки фактов: вывод получается нестабильным, и бизнес теряет доверие к AI за один провальный релиз.

В обоих случаях TTU (время от запуска до первого полезного результата) растягивает неправильно выбранный рычаг.

Оценить, где ИИ даст эффект в вашем процессе

Спектр решений на практике

Кейс Databricks Genie и Amazon Quick для автоматизации пополнения склада показывает правильный выбор рычага: раньше прогноз спроса требовал ручной настройки модели под каждый SKU, счёт шёл на десятки тысяч позиций и терял актуальность быстрее, чем планировщик успевал свести таблицы с поставщиками. Foundation-модель здесь прогнозирует спрос по всему каталогу без потарной донастройки - задача закрыта на уровне RAG и оркестрации данных, без дообучения.

Другой полюс спектра - Abnormal AI, защищающая почту у более чем 25% компаний из списка Fortune 500.

Их агенты обрабатывают миллиарды операций в день, и для детекции фишинга в реальном времени одного семантического рассуждения модели недостаточно: нужен вычислительный «черновик» - песочница для агрегации данных, верификации и анализа кода на лету.

Здесь правильный уровень кастомизации - инфраструктура вокруг модели: Bedrock AgentCore Code Interpreter даёт агенту исполняемую среду для кода, отдельную от текста промпта.

Кейс Ninth Wave в open finance - третий пример того же принципа.

Каждый банк отдаёт API с собственными названиями полей и отклонениями от стандарта FDX; сведение форматов раньше занимало недели работы специалистов по переписке и таблицам.

Задачу решает слой нормализации данных поверх модели - инженерия интеграции.

Модель в этой задаче остаётся константой, работу делает обвязка вокруг неё.

Инфраструктура вокруг модели решает не меньше самой модели

Отдельная категория задач, которую спектр кастомизации не описывает напрямую, но которая съедает не меньше инженерного времени - управление доступом агента.

Когда агент должен действовать в GitHub или Slack от имени пользователя, ему нужен OAuth-грант, привязанный именно к этому пользователю (session binding).

Раньше это писала своя команда: хранение токенов, отзыв доступа, аудит действий агента. AgentCore Identity закрывает этот слой готовой инфраструктурой.

Важен сам факт: этот слой обязателен для production, а не опционален - это стоит запомнить любой компании, которая выводит агента за пределы демо-стенда.

Эта же логика стоит за LLM & Security Gateway в контуре AI-native интеграции: без него каждый агент получает прямой доступ к внутренним системам без единой точки аудита и отзыва прав, и подключение агента к CRM превращается в дыру в периметре. Агент, который безопасно и предсказуемо работает с корпоративными данными, не появляется сам по себе - за ним стоит слой авторизации, логирования и ограничения scope, который проектируют отдельно от промпта и отдельно от модели.

Правило выбора

Перед тем как писать промпт или заказывать дообучение, стоит один раз честно ответить: решает ли задачу контекст в промпте, решает ли её RAG на актуальных данных компании, или бизнес-логика настолько специфична, что без дообучения не обойтись. Каждый следующий рычаг в этом списке стоит дороже предыдущего и оправдан только тогда, когда предыдущий доказанно не справляется.

Модель - сырьё; решение, которое приносит деньги, собирает инженер, который знает, где на этом спектре остановиться, и закладывает слой доступа и аудита вокруг агента раньше, чем агент попадёт в прод.

Обсудить статью: GenAI: модель — сырьё, результат делает…

Укажите email или телефон, чтобы мы могли вам ответить.

Отправить через: