Облачная или локальная LLM: как выбрать для больших объёмов

Как сравнить API, локальную модель и гибридный контур для обработки больших каталогов: качество, стоимость, безопасность, нагрузка и сопровождение.

  • Короткий ответ
  • Почему расчёт «цена токена × количество строк» даёт слабый прогноз
  • Три рабочих контура
  • Как посчитать экономику до внедрения

Облачная или локальная модель: что выгоднее при обработке миллионов строк

  1. 18.11.2026 Большой прайс-лист меняет экономику AI-проекта.

  2. На демонстрации модель получает несколько строк и возвращает аккуратный результат. В рабочем процессе ей приходится обработать сотни тысяч или миллионы товарных позиций, обратиться к справочникам, проверить формат ответа и повторить неудачные операции.

  3. Цена одного запроса перестаёт быть достаточным ориентиром.

  4. Сравнивать нужно стоимость одной корректно обработанной позиции: с повторами, инфраструктурой и ручной проверкой исключений.
Облачная или локальная модель: что выгоднее при обработке миллионов строк

Короткий ответ

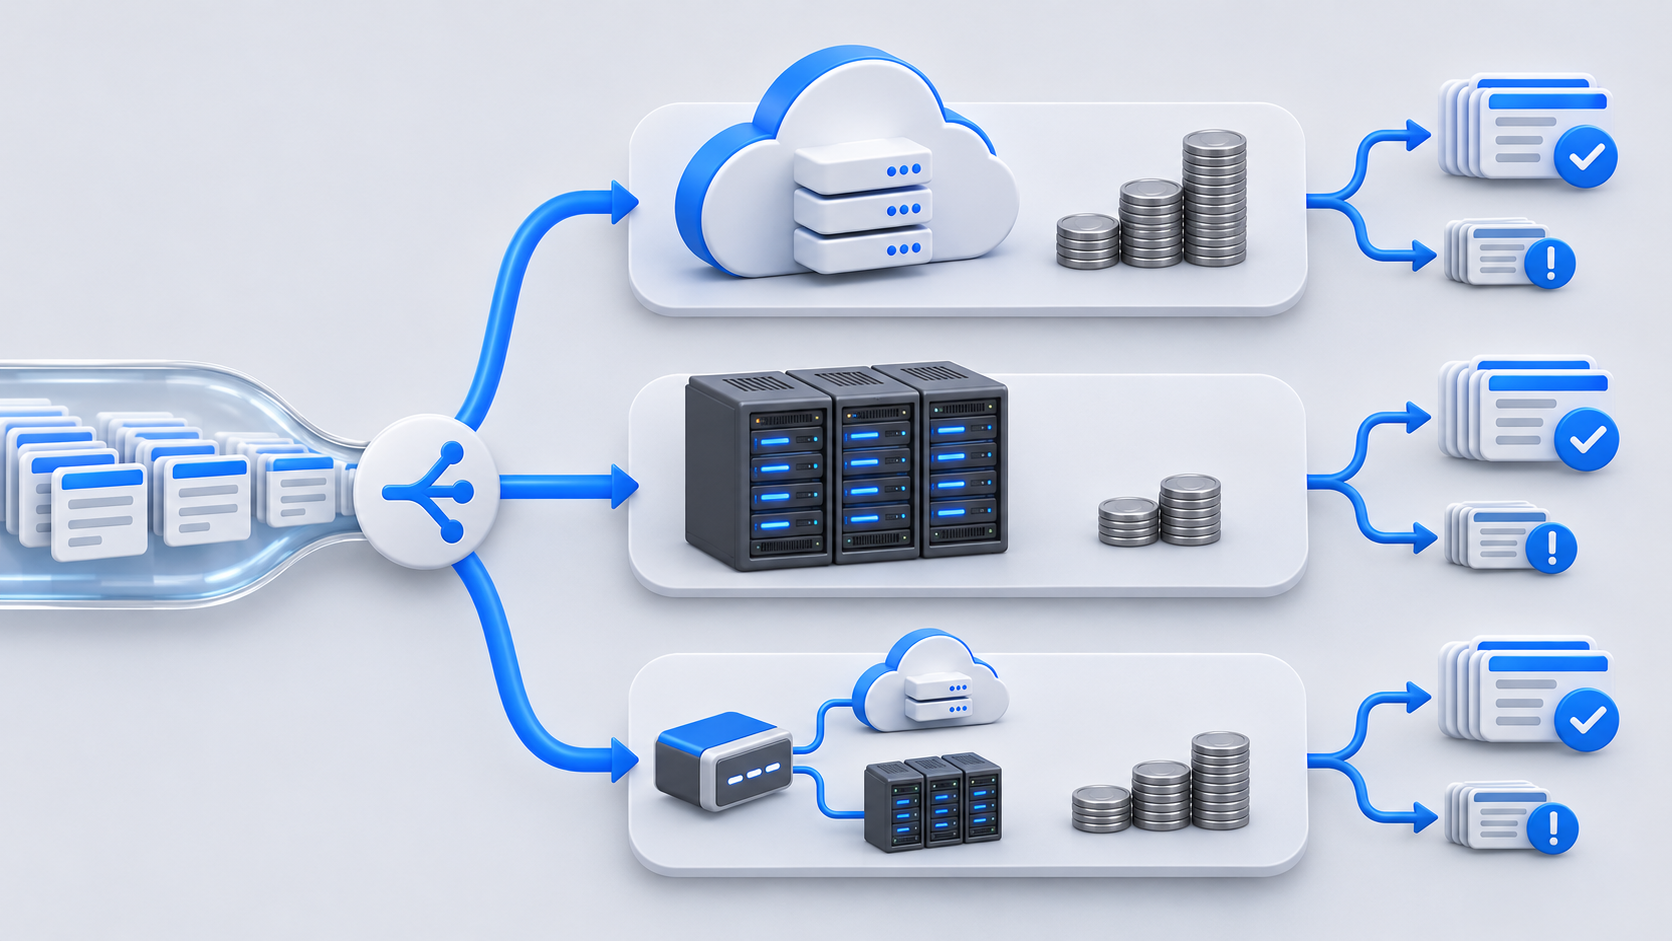
  1. - Облачный API обычно требует меньше первоначальных затрат и быстрее позволяет провести пилот. -

  2. Локальная модель становится кандидатом при постоянном большом потоке, требованиях закрытого контура и высокой загрузке оборудования. -

  3. Гибридная схема подходит, когда чувствительные данные нужно оставить внутри компании, а сложные случаи выгоднее передавать более мощной внешней модели после обезличивания. -

  4. Выбор подтверждают тестом на реальных данных.

  5. Сравнивать нужно качество, пропускную способность и полную стоимость процесса.

Почему расчёт «цена токена × количество строк» даёт слабый прогноз

Одна товарная строка редко равна одному запросу.

Система может сначала определить категорию, затем найти подходящую схему атрибутов, нормализовать значения и проверить результат.

Если исходные данные неоднозначны, появляются повторные обращения к модели или проверка экспертом.

Полная стоимость включает: 1

входные и выходные токены; 2. поиск и подготовку контекста; 3. повторные запросы после ошибок; 4. валидацию структурированного ответа; 5. хранение истории и журналов; 6. работу очередей и интеграций; 7. инфраструктуру локального контура; 8. сопровождение модели и мониторинг качества; 9. ручную проверку исключений.

Поэтому сначала измеряют стоимость небольшой репрезентативной выборки

В неё включают обычные позиции, длинные описания, пустые поля, дубли и товары с противоречивыми характеристиками.

Три рабочих контура

КонтурКогда подходитОсновные расходыГлавный риск
Облачный APIПилот, нерегулярная нагрузка, сложные рассужденияИспользование модели, интеграционный слой, контроль данныхРасходы растут вместе с объёмом; действуют ограничения по данным и сети
Локальная модельСтабильный большой поток, закрытый контур, доступная инфраструктураGPU, эксплуатация, обновления, мониторингНизкая утилизация оборудования или недостаточное качество модели
ГибридРазные классы данных и сложностиДва контура, маршрутизация, обезличиваниеСложнее правила маршрутизации и диагностика

Google Cloud рекомендует выбирать модель и среду выполнения по сложности задачи, стоимости и задержке, а простые запросы направлять более компактным моделям. Эта логика применима и вне конкретного облака: не каждую строку должен обрабатывать самый дорогой контур.

Как посчитать экономику до внедрения

Шаг Разделить поток на классы Например: - простая нормализация известного поля; - классификация товара; - сопоставление с внутренним справочником; - поиск недостающих характеристик; - разбор противоречий; - исключение, требующее решения человека. Часть операций можно выполнить правилами, поисковым индексом или небольшой моделью. AI имеет смысл подключать там, где требуется работа с неструктурированным содержанием или неоднозначностью. Шаг

Зафиксировать критерий качества Для каждого класса нужен проверяемый результат: корректная категория, валидный JSON, правильное значение атрибута, найденный источник, отсутствие запрещённого изменения. Субъективной оценки ответа недостаточно: для каждого класса данных нужны проверяемые критерии качества. Шаг

Прогнать одинаковую выборку Облачная и локальная модели получают один набор данных и одинаковые правила. Для каждой фиксируют: - долю результатов, прошедших автоматическую проверку; - долю ручных исключений; - время обработки; - объём входного и выходного контекста; - количество повторных попыток; - фактические расходы на тестовый пакет. Шаг

Пересчитать на рабочую нагрузку Базовая формула: > Полная стоимость периода = модель или инфраструктура + интеграции и хранение + эксплуатация + ручная обработка исключений. Для локального контура важно считать загрузку GPU. Оборудование с низкой утилизацией может оказаться дороже API. При постоянной очереди ситуация меняется: фиксированная инфраструктура распределяется на большой объём операций. Шаг

Проверить чувствительность Расчёт повторяют для нескольких сценариев: обычный месяц, пик, рост каталога, ухудшение входных данных. Такой диапазон полезнее одной итоговой цифры.

Когда локальная модель оправдана

  1. Под локальным контуром здесь понимается модель, работающая на инфраструктуре под контролем компании.

  2. Собственное оборудование, частное облако и арендованный GPU имеют разную экономику, поэтому их нужно считать отдельно.

  3. Локальный контур стоит включать в сравнение, если одновременно выполняются несколько условий: - нагрузка достаточно постоянна; - данные нельзя отправлять внешнему провайдеру; - процесс допускает модель меньшего размера; - команда готова обслуживать инфраструктуру; - есть измеримый набор для контроля качества; - требуется предсказуемая пропускная способность.

  4. Сам факт размещения модели внутри компании не гарантирует низкую стоимость.

  5. Нужны мониторинг загрузки, обновления, резервирование и понятная ответственность за эксплуатацию.

Оценить, где ИИ даст эффект в вашем процессе

Когда облачный API рациональнее

API обычно выигрывает на старте: не требуется заранее покупать мощность, можно быстро проверить несколько моделей, а расходы следуют за фактической нагрузкой. Он также полезен для редких сложных случаев, где небольшая модель даёт слишком много ошибок. Ограничения нужно зафиксировать до пилота: какие данные уходят наружу, где обрабатываются, что сохраняется провайдером и как работает система при недоступности внешнего сервиса.

Практичная гибридная схема

Рабочий поток можно разделить: 1. правила и обычный код выполняют форматирование и очевидные проверки; 2. локальная модель обрабатывает массовые стандартные позиции; 3. маршрутизатор выделяет сложные случаи; 4. чувствительные поля обезличиваются; 5. внешняя модель получает только необходимый контекст; 6. результат проходит детерминированную проверку; 7. спорные случаи попадают в очередь эксперта. Такой контур требует больше проектирования, зато позволяет отдельно управлять стоимостью, качеством и рисками данных.

Какие данные нужны для решения

До выбора модели соберите: - объём строк за день и месяц; - средний и пиковый размер записи; - допустимое время обработки; - перечень чувствительных полей; - долю стандартных и сложных случаев; - стоимость ручной обработки исключения; - требования к доступности; - текущие системы и способы интеграции. После этого можно провести короткий сравнительный прогон и получить диапазон стоимости. Без этих входных данных спор о локальной и облачной модели остаётся сравнением технологий без привязки к процессу.

Пример расчётной карточки

Для сравнения не нужны выдуманные рыночные цены. Достаточно заполнить карточку своими данными: объём записей за период, средний размер контекста, доля повторных вызовов, доля ручных исключений, стоимость часа эксперта, загрузка оборудования, расходы на эксплуатацию и требуемая доступность. Затем для каждого варианта рассчитывается стоимость всех успешно обработанных записей, а не стоимость отдельного вызова.

Вывод

Для массовой обработки данных нет универсально дешёвого контура. Облачный API снижает порог пилота, локальная модель может выиграть на постоянном объёме, гибрид разделяет задачи по сложности и чувствительности. Решение подтверждает одинаковый тестовый набор и расчёт полной стоимости корректно обработанной позиции. KT.Team может подготовить тестовую выборку, сравнить варианты на одинаковых критериях и собрать финансовую модель с диапазоном нагрузки и долей ручных исключений.

FAQ

FAQ

Можно ли начать с API, а затем перейти на локальную модель?

Да, если интеграционный слой отделён от конкретного провайдера, а входы, выходы и критерии качества зафиксированы. Тогда локальную модель можно подключить как ещё один маршрут.

Нужно ли отправлять каждую строку в LLM?

Нет. Форматирование, словарные замены, проверка типов и часть сопоставлений надёжнее и дешевле выполнять обычным кодом.

Что важнее для расчёта: токены или число товарных позиций?

Нужны оба показателя, но итог определяет стоимость корректного результата с учётом повторов и ручных исключений.

Источники

- Google Cloud Architecture Center. AI and ML cost optimization: https://docs.cloud.google.com/architecture/framework/perspectives/ai-ml/cost-optimization - Google Cloud Architecture Center. Choosing agentic AI architecture components: https://docs.cloud.google.com/architecture/choose-agentic-ai-architecture-components - NIST. Generative AI Profile: https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf

Обсудить статью: Облачная или локальная LLM: как выбрать…

Укажите email или телефон, чтобы мы могли вам ответить.

Отправить через: