Отказоустойчивость AI: почему прод важнее демо

Почему AI-пилот ломается в проде: сбои обучения, ошибки reasoning-агентов, устаревшие промпты и неточная редакция данных - и как это чинят инженерией.

  • Почему обучение падает на третьи сутки
  • Модель знает правило, но не умеет им пользоваться
  • Промпт нельзя один раз написать и забыть
  • Точность - это не только про детекцию

Главное

AWS в один день выкатил четыре инженерных разбора: отказоустойчивое распределённое обучение на Amazon EKS, агентные skills для медицинского reasoning, автоматическая оптимизация системных промптов в Bedrock AgentCore и serverless-пайплайн для редакции персональных данных. Разные задачи, один диагноз: демо AI ломается на первом же сбое, а прод - нет, потому что прод спроектирован под сбой заранее.

Почему обучение падает на третьи сутки

  1. Распределённое обучение большой модели идёт часами и днями на десятках узлов.

  2. На таком масштабе сбой не риск, а статистика: сетевой партишн, битая память, исключение в коде, отказ инфраструктуры - что-то из этого случится обязательно. AWS описывает типичный каскад: один GPU падает, NCCL-таймаут расползается на здоровые воркеры, поды рестартуют не синхронно, кластер жжёт дорогие GPU-часы и не двигает обучение ни на шаг.

  3. Синхронный чекпоинтинг усугубляет проблему: каждое сохранение блокирует всех воркеров разом. NVRx на EKS сокращает потери от сбоя с часов простоя до минут - устранить сами сбои технически нельзя.

  4. Это и есть TTU в чистом виде: ценность обучающей инфраструктуры не в пиковой скорости на здоровом кластере, а во времени возврата к полезной работе после отказа.

  5. Красивый бенчмарк на демо-стенде ничего не говорит о том, что случится на 40-й час на 32 узлах.

Модель знает правило, но не умеет им пользоваться

  1. Второй разбор - про агентов в healthcare и life sciences.

  2. Модель попросили классифицировать миссенс-вариант TP53 по критериям ACMG/AMP.

  3. Она называет правильный фреймворк - и тут же путает категории доказательств, пропускает порог популяционной частоты или придумывает несуществующий предсказательный скор.

  4. Модель знает факты, но не имеет структурированной процедуры рассуждения, которую практик нарабатывает годами.

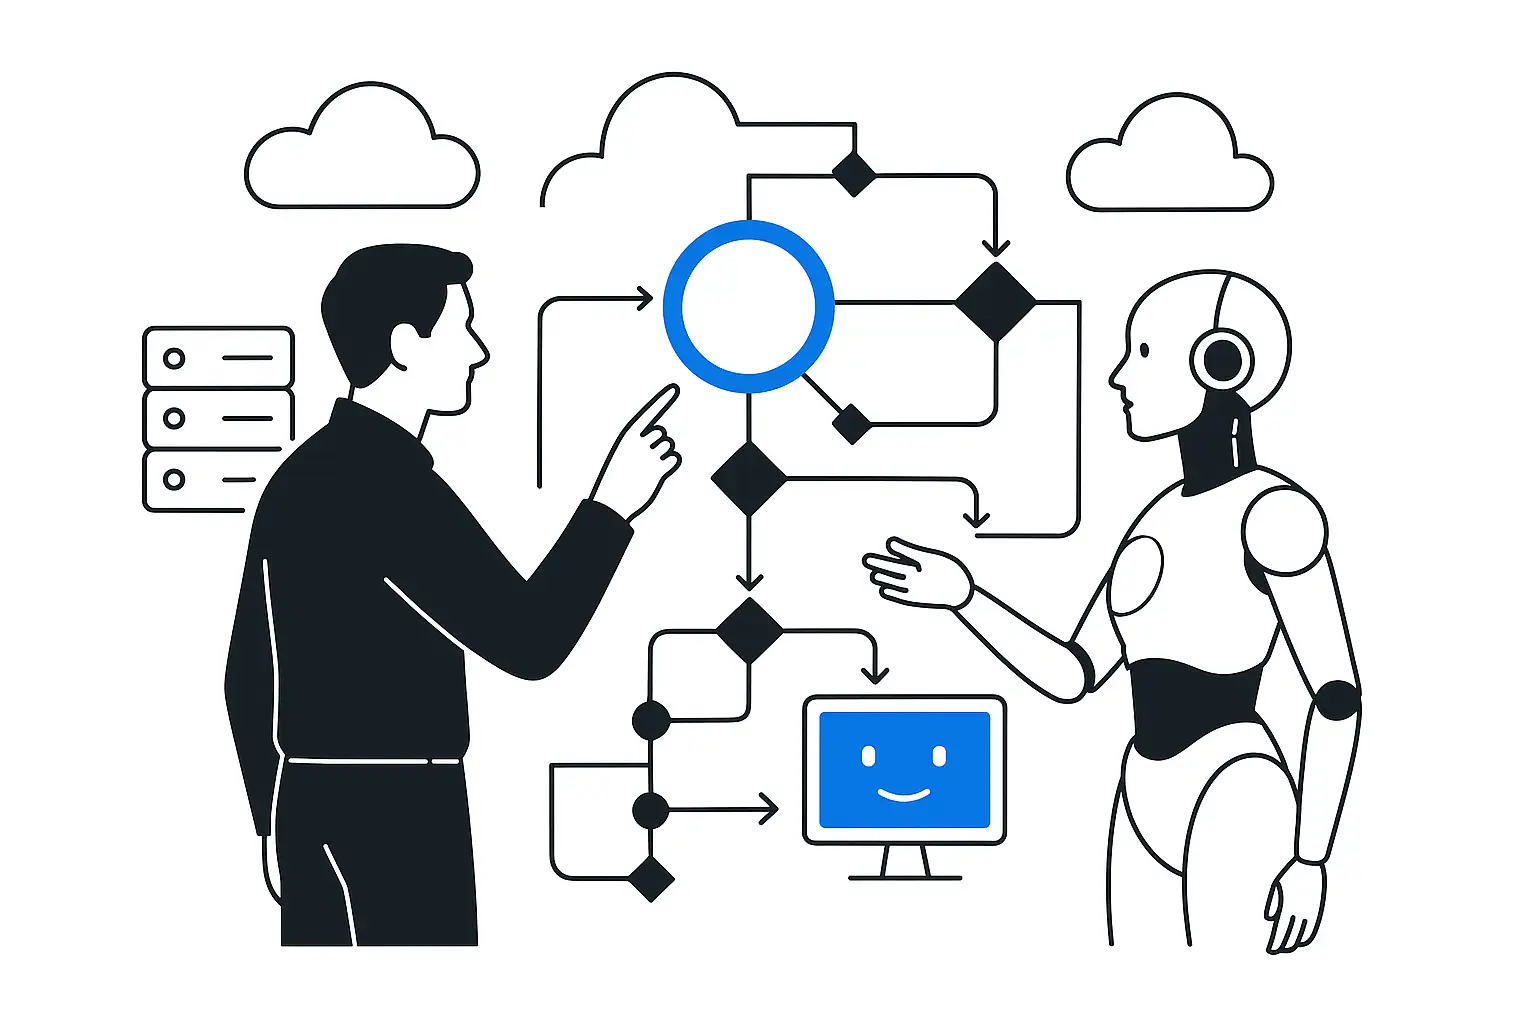
  5. Ошибка тихая: ответ выглядит уверенно и профессионально, а по сути неверен. AWS чинит это agent skills: явно описанной процедурой рассуждения, которую агент обязан пройти шаг за шагом вместо восстановления по памяти.

  6. Тот же принцип лежит в основе MCP: протокол работы с инструментом фиксируется снаружи модели, в структуре, которую можно проверить и версионировать, вместо того чтобы модель угадывала его сама.

Оценить, где ИИ даст эффект в вашем процессе

Промпт нельзя один раз написать и забыть

Bedrock AgentCore решает соседнюю проблему: улучшение агента раньше было ручной работой - читать длинные трейсы, крутить промпты и описания инструментов, перезапускать оценку и смотреть, стало ли лучше. AgentCore optimization берёт продовые трейсы, сам предлагает изменения конфигурации, проверяет их офлайн-оценкой и онлайн A/B на живом трафике - и только после этого продвигает. Это конвейер обратной связи: агент, который не пересматривается по продовым данным, деградирует незаметно для всех, кроме пользователей.

Точность - это не только про детекцию

Четвёртый кейс - редакция PII в потоке сканированных документов: медицинские формы, страховые claims, финансовые записи. Ручная редакция не масштабируется: часы работы людей, человеческие ошибки, комплаенс-риск на каждой странице. AWS отдельно подчёркивает: у редакции есть вторая задача помимо детекции - точность. На одной странице может быть несколько имён, дат и адресов, и не каждое из них персональные данные в контексте конкретного use case.

Serverless-пайплайн на Bedrock Data Automation применяет контекстное правило вместо слепого вычёркивания всего, что похоже на имя.

Вывод для покупателей AI

Все четыре истории об одном: production-grade AI - это не модель с хорошим бенчмарком, а система, где заранее описано, что происходит при отказе узла, при неверно применённом правиле рассуждения, при устаревшем промпте и при избыточной редакции данных. Агент, который стабильно и точно отвечает на прод-трафике, выглядит просто.

За этой простотой стоит инженерия:

  • чекпоинтинг с быстрым восстановлением
  • явные skills вместо надежды на здравый смысл модели
  • конвейер переоценки промптов на реальных данных
  • контекстные правила точности вместо общей эвристики

Перед тем как принять AI-пилот в прод, стоит задать не вопрос «какая точность на тестовом наборе»

, а вопрос «что произойдёт через час после первого сбоя и за сколько минут система вернётся к полезной работе». Если на это нет ответа - есть демо, а не production-система. В проектах, где мы в KT.Team ставим RAG-контуры и agent-пайплайны на MCP, именно этот вопрос закрывается в первую очередь - до того, как система увидит боевой трафик, а не после первого инцидента.

Источник

Обсудить статью: Отказоустойчивость AI: почему прод важнее…

Укажите email или телефон, чтобы мы могли вам ответить.

Отправить через: