Латентность убивает AI-автоматизацию раньше бюджета

Спрос на AI automation engineer растёт, но продовые AI-воркфлоу тормозят на цепочках LLM-вызовов. Разбор трёх паттернов, которые реально ускоряют пайплайны

  • Спрос обгоняет инженерию
  • Где ломается «простой» воркфлоу
  • Три паттерна, которые реально работают
  • Как это выглядит, когда сделано всерьёз

Спрос обгоняет инженерию

  1. На форуме n8n сейчас висят рядом вакансия AI automation engineer на удалёнку и разбор латентности AI-воркфлоу от команды n8n.

  2. Совпадение не случайное: спрос на AI-автоматизацию растёт быстрее, чем инженерная культура, которая делает её быстрой и надёжной в проде. Рекрутинговая компания из

  3. Нидерландов ищет фрилансера собирать автоматизации на n8n и Make: операции с рекламой в Meta, скрапинг LinkedIn и Indeed для outreach, дашборды и отчётность. В соседней ветке того же форума фрилансер выигрывает проект: детерминированные тесты пайплайна и обработка ошибок и ретраев перевешивают портфолио из десятков ботов.

  4. Компании больше не покупаются на эффектные демо.

  5. Они спрашивают про тесты, обработку ошибок и повторные попытки при сбое.

Где ломается «простой» воркфлоу

  1. Один вызов модели отвечает за доли секунды.

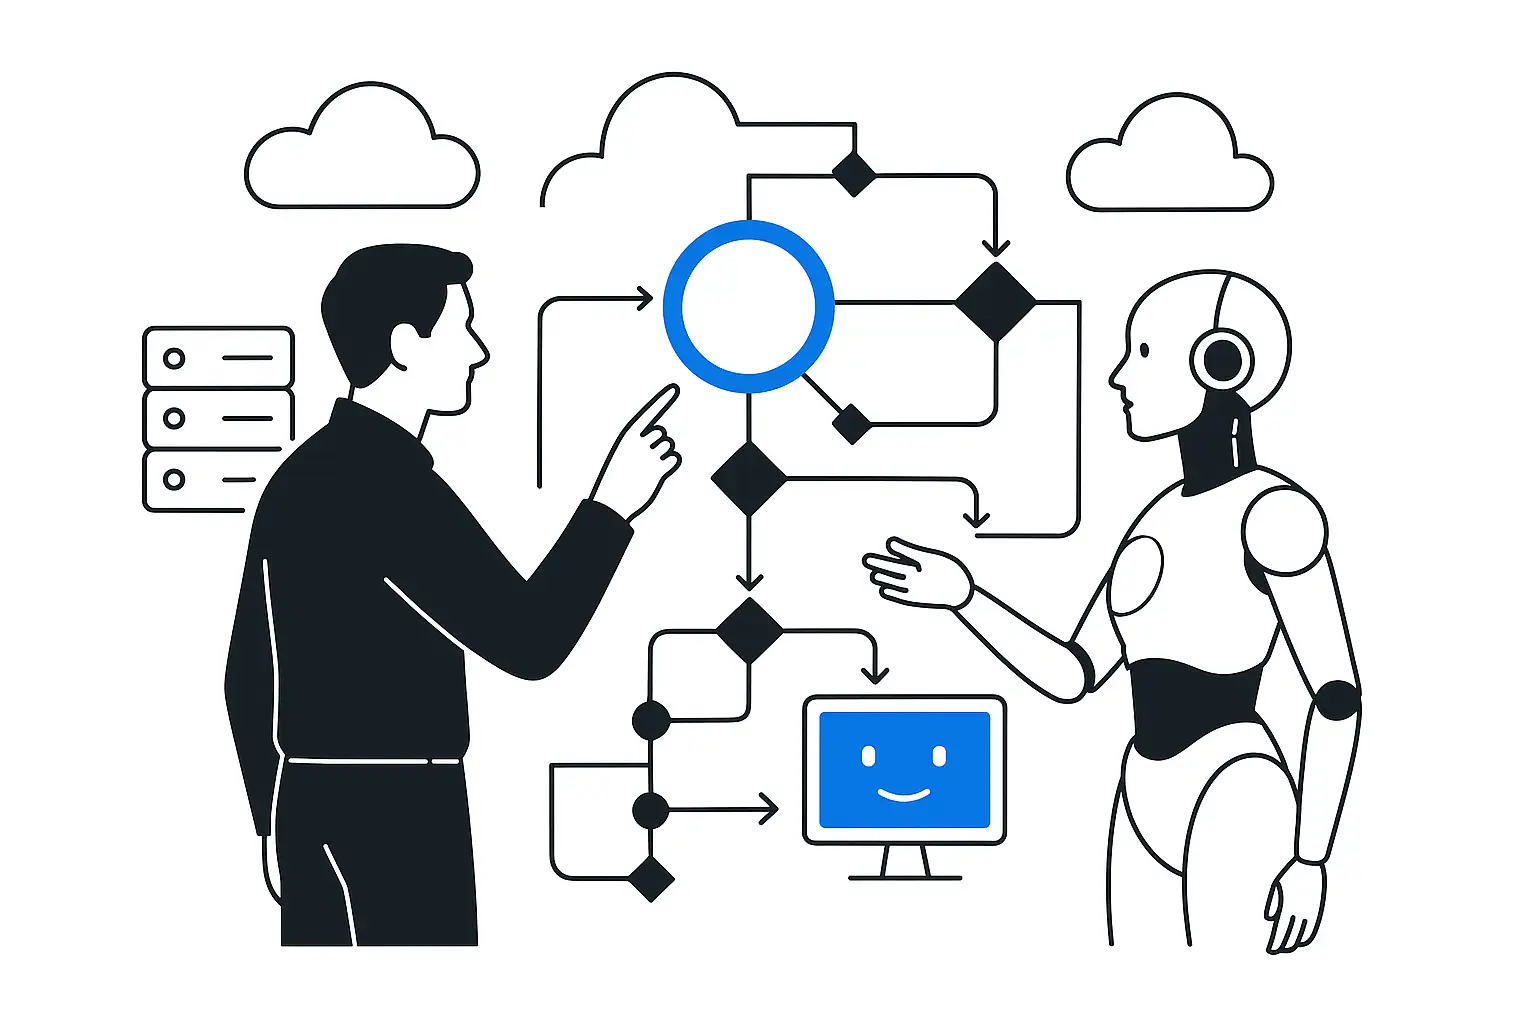
  2. Продовый AI-воркфлоу - цепочка вызовов: вебхук принимает запрос → LLM классифицирует его → второй вызов достаёт контекст → третий формирует ответ → четвёртый проверяет тон. Каждый шаг ждёт предыдущий.

  3. Пользователь получает ответ через 8-12 секунд вместо 1-2.

  4. Причина в архитектуре: вызовы модели ждут друг друга в очереди, хотя часть из них не зависит друг от друга и может идти параллельно.

Три паттерна, которые реально работают

  1. - Параллельное исполнение: шаги без взаимной зависимости - например, оценка тона и поиск контекста - выполняются одновременно; платформа вроде n8n держит это на уровне графа, без ручного кода. -

  2. Таймаут на каждый вызов модели: без него одна зависшая LLM-нода держит весь воркфлоу и всех, кто стоит за ним в очереди. -

  3. Кэш на повторяющиеся запросы: одинаковый вопрос второй раз не идёт в модель заново - экономит и время, и токены.

  4. Все три паттерна закрывает архитектура платформы и процесс вокруг неё.

  5. Удачная формулировка промпта тут бессильна.

Оценить, где ИИ даст эффект в вашем процессе

Как это выглядит, когда сделано всерьёз

  1. Показательный пример с того же форума - публичный проект поддержки книжного магазина на n8n.

  2. Вебхук принимает вопрос, текст нормализуется, запрос делится на текстовый и нетекстовый маршрут, дальше семантический поиск через Gemini Embeddings и pgvector в Supabase, ветвление по уверенности ответа, безопасный fallback при низкой уверенности, логирование каждого взаимодействия и отдельный пайплайн, обновляющий базу знаний.

  3. Восемь стадий ради одного чат-бота поддержки.

  4. Каждая стадия - точка, где может утечь секунда или сломаться логика.

  5. Простой результат для пользователя здесь стоит нетривиальной инженерии на стороне того, кто его строил.

Что это значит для бизнеса

Компания, которая нанимает automation engineer, платит за время до результата. Сам факт существования воркфлоу её не интересует. Если пайплайн отвечает за 10 секунд вместо одной, TTU (time to use) продукта падает, и метрика, ради которой всё затевалось - конверсия чата, скорость обработки лида, - не двигается. AI, который увеличивает время до результата, - это театр с процессором, даже если каждый отдельный вызов модели работает исправно.

В KT.Team этот же принцип держит любую AI-native интеграцию: LLM Gateway между приложением и моделью существует, чтобы таймауты, ретраи и кэш жили в одном месте архитектуры вместо того, чтобы вручную расползаться по нодам n8n и коду на Python.

Вывод

Спрос на AI automation engineers растёт, потому что бизнес готов платить за автоматизацию. Платит он за скорость результата. Эту скорость закладывает архитектура воркфлоу с первого дня. Latency-патч после первой жалобы пользователя её уже не создаёт - только чинит то, что должно было работать сразу.

Обсудить статью: Латентность убивает AI-автоматизацию…

Укажите email или телефон, чтобы мы могли вам ответить.

Отправить через: